Redis
数据结构
| 数据结构 | 底层实现(Redis 7.0) | 最大元素数量 | 典型用途 |
|---|---|---|---|
| String | SDS(简单动态字符串) | 512 MB | 缓存对象、计数器、分布式锁 |
| Hash | Dict + ListPack(小) | 2³²-1 个 field | 对象存储(如用户信息) |
| List | QuickList(双向链表) | 2³²-1 个元素 | 消息队列、最新消息列表 |
| Set | Dict + IntSet(整数) | 2³²-1 个元素 | 去重、标签、共同好友 |
| Sorted Set | SkipList + Dict | 2³²-1 个元素 | 排行榜、延时队列、加权任务 |
| Bitmap | String(位操作扩展) | 2³²-1 位 | 签到、在线状态、布隆过滤器 |
| HyperLogLog | 特殊概率结构 | ~2⁶⁴ 个基数 | UV统计(近似去重) |
| Geo | Sorted Set 封装 | 2³²-1 个元素 | 附近的人、地理围栏 |
| Stream | Radix Tree + ListPack | 无限(可裁剪) | 消息队列(持久化、消费者组) |
1. String(字符串)—— 最常用的原子操作
| 原子命令 | 作用 | 返回值 | 并发安全场景 |
|---|---|---|---|
SET key value [EX seconds] [NX/XX] |
设置值(带条件) | OK / nil | 分布式锁(NX + EX) |
GETSET key newvalue |
设置新值,返回旧值 | 旧值 | 原子性更新+获取 |
INCR key / DECR key |
值+1 / -1 | 新值 | 计数器、库存扣减 |
INCRBY key increment |
增加指定整数 | 新值 | 精确计数 |
INCRBYFLOAT key increment |
增加浮点数 | 新值 | 金额/评分计算 |
SETNX key value |
不存在才设置 | 1/0 | 分布式锁(老版本) |
MSETNX key1 v1 key2 v2 ... |
多个Key都不存在才全部设置 | 1/0 | 批量原子创建 |
APPEND key value |
追加内容 | 新长度 | 日志拼接 |
GETRANGE key start end |
截取子串 | 子串 | 读取部分数据(只读) |
STRLEN key |
获取长度 | 长度 | 只读 |
GET+SET分开执行不是原子的,必须用GETSET或 Lua 脚本。
2. Hash(哈希)—— 字段级别的原子操作
| 原子命令 | 作用 | 并发安全场景 |
|---|---|---|
HSET key field value |
设置字段 | 更新对象单个属性 |
HSETNX key field value |
字段不存在才设置 | 防止重复设置 |
HINCRBY key field increment |
字段整数增减 | 用户积分、商品某个属性计数 |
HINCRBYFLOAT key field increment |
字段浮点数增减 | 金额、评分 |
HDEL key field [field ...] |
删除字段 | 移除属性 |
HEXISTS key field |
判断字段是否存在 | 检查(只读) |
HGET key field |
获取字段值 | 读取(只读) |
HGETALL key |
获取所有字段和值 | 读取(只读,注意大Key) |
HMSET key field1 v1 field2 v2 ... |
批量设置 | 批量更新(原子) |
HMGET key field1 field2 ... |
批量获取 | 批量读取(原子) |
典型场景:用户信息存储 HSET user:1001 name "张三" age 25,HINCRBY user:1001 age 1 原子增加年龄。
3. List(列表)—— 队列/栈操作的原子性
| 原子命令 | 作用 | 并发安全场景 |
|---|---|---|
| 左侧操作 | ||
LPUSH key value [value ...] |
左侧插入一个或多个 | 消息入队 |
LPOP key [count] |
左侧弹出 | 消息出队(阻塞队列用BRPOP) |
LINDEX key index |
按索引获取元素 | 读取(只读) |
LSET key index value |
按索引设置元素 | 更新指定位置 |
| 右侧操作 | ||
RPUSH key value [value ...] |
右侧插入 | 消息入队 |
RPOP key [count] |
右侧弹出 | 消息出队 |
| 阻塞操作 | ||
BLPOP key1 key2 timeout |
左侧阻塞弹出 | 消费者等待消息 |
BRPOP key1 key2 timeout |
右侧阻塞弹出 | 消费者等待消息 |
BRPOPLPUSH source dest timeout |
右侧弹出+左侧推入 | 安全队列(原子转移) |
LMOVE source dest LEFT/RIGHT |
元素转移(原子) | 任务队列可靠处理 |
| 其他 | ||
LREM key count value |
删除指定元素 | 清理数据 |
LTRIM key start stop |
裁剪列表 | 保留最新N条(如消息列表) |
LLEN key |
获取长度 | 只读 |
典型场景:秒杀消息队列 LPUSH queue:seckill orderId,消费者 BRPOP queue:seckill 0。
4. Set(集合)—— 去重和关系运算原子操作
| 原子命令 | 作用 | 并发安全场景 |
|---|---|---|
| 基础操作 | ||
SADD key member [member ...] |
添加元素 | 标签添加、去重 |
SREM key member [member ...] |
删除元素 | 取消标签 |
SMOVE source dest member |
移动元素(原子) | 状态流转 |
SPOP key [count] |
随机弹出 | 抽奖 |
SRANDMEMBER key [count] |
随机获取(不删除) | 随机展示(只读) |
SISMEMBER key member |
判断是否存在 | 权限检查 |
| 集合运算(均为原子) | ||
SINTER key1 key2 ... |
交集 | 共同好友 |
SUNION key1 key2 ... |
并集 | 合并标签 |
SDIFF key1 key2 ... |
差集 | 推荐未关注的人 |
SINTERSTORE dest key1 key2 |
交集并存储 | 缓存计算结果 |
SUNIONSTORE dest key1 key2 |
并集并存储 | 缓存计算结果 |
SDIFFSTORE dest key1 key2 |
差集并存储 | 缓存计算结果 |
SCARD key |
获取集合大小 | 只读 |
典型场景:共同好友 SINTER user:1001:friends user:1002:friends。
5. Sorted Set(有序集合)—— 带权重的原子操作
| 原子命令 | 作用 | 并发安全场景 |
|---|---|---|
| 添加/更新 | ||
ZADD key [NX/XX] [GT/LT] score member [score member ...] |
添加/更新成员和分数 | 更新排行榜分数 |
ZINCRBY key increment member |
增加成员分数 | 原子加分(如点赞+1) |
| 删除 | ||
ZREM key member [member ...] |
删除成员 | 移除排名 |
ZREMRANGEBYRANK key start stop |
按排名删除 | 清理底部排名 |
ZREMRANGEBYSCORE key min max |
按分数删除 | 清理过期数据 |
| 查询 | ||
ZRANK key member / ZREVRANK |
获取排名 | 查询用户排名(只读) |
ZSCORE key member |
获取分数 | 查询分数(只读) |
ZRANGE key start stop [WITHSCORES] |
按排名获取 | 获取Top N(只读) |
ZREVRANGE key start stop [WITHSCORES] |
按排名倒序获取 | 获取Top N(只读) |
ZRANGEBYSCORE key min max |
按分数范围获取 | 分段查询 |
| 集合运算(原子) | ||
ZUNIONSTORE dest numkeys key [key ...] |
并集并存储 | 合并多个排行榜 |
ZINTERSTORE dest numkeys key [key ...] |
交集并存储 | 共同加权排名 |
ZCARD key |
获取总个数 | 只读 |
ZCOUNT key min max |
统计分数区间个数 | 只读 |
典型场景:游戏排行榜 ZINCRBY game:ranking 10 "player:1001"。
6. Bitmap(位图)—— 极省内存的原子操作
本质是 String,但操作的是位级别
| 原子命令 | 作用 | 并发安全场景 |
|---|---|---|
SETBIT key offset value |
设置某一位为0/1 | 签到标记(原子) |
GETBIT key offset |
获取某一位 | 查询签到状态(只读) |
BITCOUNT key [start end] |
统计1的个数 | 统计签到天数 |
BITPOS key bit [start end] |
查找第一个0/1的位置 | 查找缺失/连续 |
BITOP AND/OR/XOR/NOT dest key [key ...] |
位运算(原子) | 多用户签到交集统计 |
BITFIELD key [GET/SET/INCRBY] |
操作多个位字段 | 原子操作多个子字段 |
典型场景:用户签到 SETBIT user:1001:sign:2026 0 1(第0天签到)。
7. Geo(地理位置)—— 基于 Sorted Set
| 原子命令 | 作用 | 并发安全场景 |
|---|---|---|
GEOADD key longitude latitude member [member ...] |
添加位置 | 更新位置(原子) |
GEOPOS key member [member ...] |
获取经纬度 | 查询位置(只读) |
GEODIST key member1 member2 [unit] |
计算两点距离 | 计算距离(只读) |
GEORADIUS key lon lat radius unit |
范围查询(圆心) | 附近的人(只读) |
GEORADIUSBYMEMBER key member radius unit |
范围查询(成员为中心) | 附近的人(只读) |
GEOSEARCH key [FROMMEMBER/FROMLONLAT] |
更灵活的范围搜索 | 复杂地理查询(只读) |
集群
历史
为了解决单机故障,采取主从模式
主从模式主机挂了,需要人为将slave节点换成master节点,然后引入哨兵模式,它能自动换节点。
但以上模式都是每个服务存储所有数据,所以redis cluster就诞生了,实现数据分片存储,此外还有Twemproxy、Codis等也是分片存储
主从模式
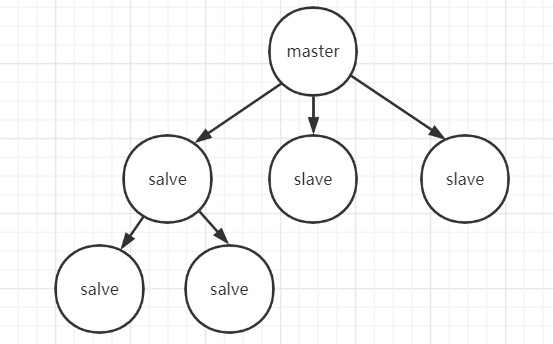
优点: 主从结构具有读写分离,提高效率、数据备份,提供多个副本等优点。
不足: 不具备自动容错和恢复功能,主节点故障,集群则无法进行工作,可用性比较低,需要人工手动干预。
主数据库崩溃时,需要手动切换从数据库成为主数据库:
在从数据库中使用SLAVE NO ONE命令将从数据库提升成主数据
启动之前崩溃的主数据库,然后使用SLAVEOF命令将其设置成新的主数据库的从数据库,同步数据
哨兵模式
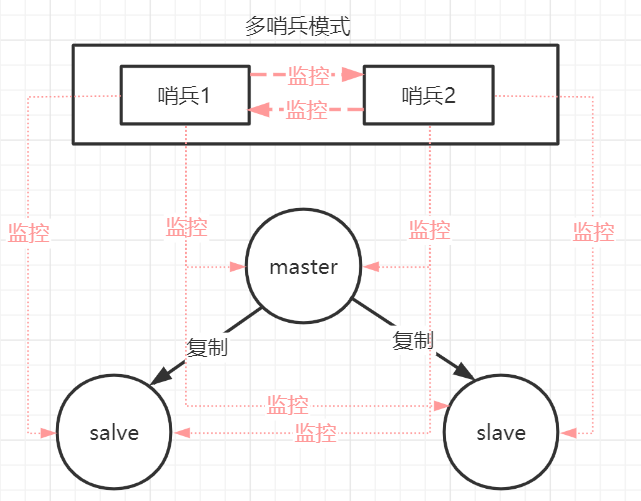
哨兵模式还是主从复制,只是在主节点挂掉之后,多了一个竞选机制:从所有的从节点竞选出新的主节点。竞选机制的实现,是依赖于在系统中启动一个sentinel进程。
哨兵也可以有多个,这样哨兵也能互相监控
优点:解决了主从模式中master故障不可以自动切换故障的问题
不足:只有主机接收处理请求,所有集群存储全量数据,浪费空间。投票选举时,未选出主机,这时集群是保护机制,禁止写操作。
Redis Cluster
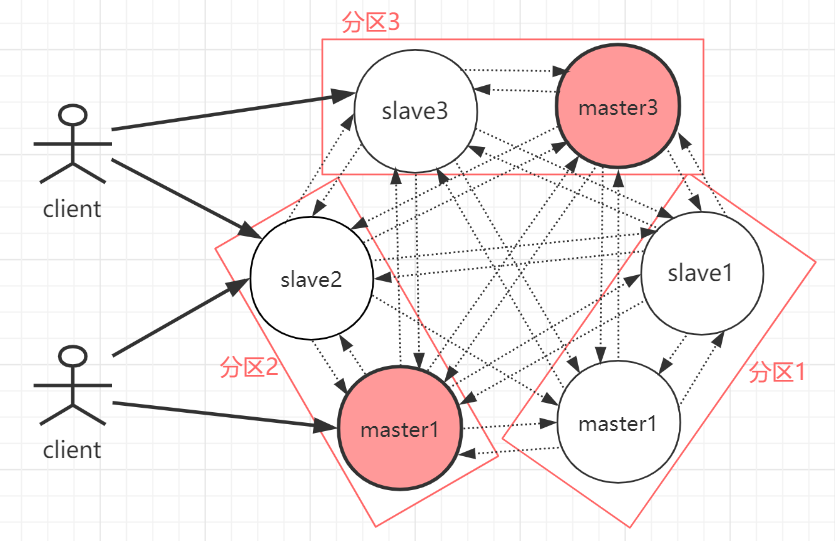
集群完全去中心化,采用多主多从;所有的redis节点彼此互联(PING-PONG机制)
客户端与 Redis 节点直连,不需要中间代理层。客户端不需要连接集群所有节点,连接集群中任何一个可用节点即可。
每一个分区都是由一个Redis主机和多个从机组成,分片和分片之间是相互平行的。
每一个master节点负责维护一部分槽,以及槽所映射的键值数据;集群中每个节点都有全量的槽信息,通过槽每个node都知道具体数据存储到哪个node上。